把「拉数据 → 出大纲 → 出片」拆成三个各司其职的 Skill——AI 负责理解与撰写,Skill 负责口径与结构,代码只做确定性的事。
Skill 案例 · 报告自动化 · 2026
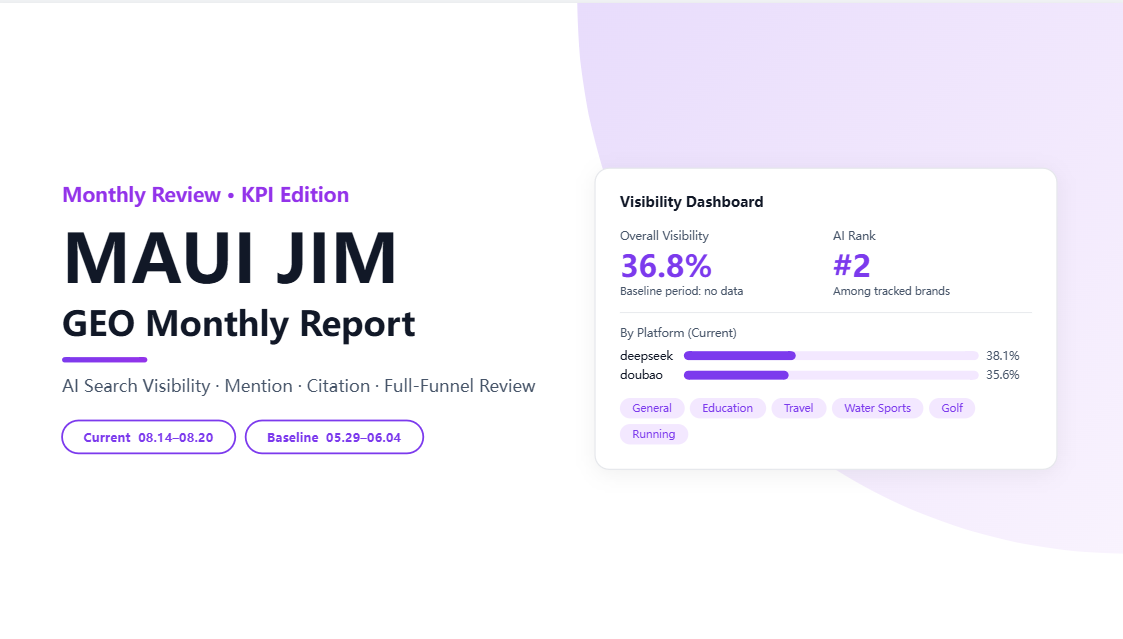
| 项 | 内容 |
|---|---|
| 类型 | Skill 案例 · 报告生产工作流 |
| 场景 | 品牌 AI 搜索可见性(GEO)月度复盘 |
| 形态 | 三个 Skill 串联:数据与大纲 → 格式转换 → 幻灯片渲染 |
| 输入 | 品牌资产标识 + 报告期 + 对比期(缺一项必须反问,禁止猜) |
| 输出 | 可编辑 .pptx,按大纲章节逐页映射 |
| 报告结构 | 6 大板块 + 附录 |
| 视觉体系 | 模板 + 设计 token,不使用渲染器默认配色 |
| 落地位置 | 技能包只留模板;真实报告落用户项目目录,不回写技能包 |
三个具体的痛点:
目标很明确:让数据自动来,让结构只调一次,让人只做判断。
数据与大纲       拉真实数据 → 组装 → 按模板生成 Markdown
                  (并负责「改大纲」的人机来回)
      │
格式约束         Markdown → PPT 的结构映射与视觉规范
                  (不自己渲染,只交付约束)
      │
渲染             真正生成可编辑 .pptx
用户体感是一句话:说一句「给我这个月的复盘报告」,然后对着大纲说几句人话,确认,出片。
关键分工:上游 Skill 只产 Markdown,不内嵌任何导出逻辑;中间的转换层只管「怎么映射、用什么配色」;实际渲染交给通用渲染 Skill。任何一层都不越界。
模型生成一段带百分比的结论是零成本的,风险也正在这里——编出来的数值和真数值,读起来一模一样。
所以最硬的一条约束是数据真实性:所有数值必须来自真实接口返回,禁止编造;缺失时明确标注「数据缺失,需补充」,不许用占位符或假设值填。
报告里也不允许出现「当期」「对比期」这类相对描述,必须写真实日期。因为一页幻灯片被单独截图发出去时,「对比期」三个字没有任何信息量。指标旁必须带日期也是同一个道理——07-01~07-31 68.5% | 对比 06-01~06-30 65.3% 是可追溯的,裸写 68.5% 不是。
报告是分析师的观点,不是 AI 的创作。但模型看到「摘要」,第一反应就是改成「Executive Summary」;看到两个小章节,顺手就想合并。
所以把结构写成硬约束,并配了一份「想犯错时先停」的自查清单:
| 约束 | 内容 |
|---|---|
| 大纲即结构 | 严格按章节逐页映射,不得重组、合并或拆分 |
| 标题照抄 | 不得概括、翻译或改写(含序号) |
| 禁止搬移 | 任何数据不得从 A 章节挪到 B 章节 |
| 指标带时间 | 数值旁必须标当期与对比期,禁止裸数值 |
| 图表必须呈现 | 大纲里的折线图、柱状图必须在 PPT 里真的画出来,不能用表格糊弄 |
对应的自查项写得很直白:「想润色标题更专业 → 违反标题照抄」「想补大纲没有的数据 → 违反内容对应」。把模型的直觉动作直接标成错误项,比事后检查有效。
每个客户的口径和章节取舍都不同。第一次调好的结构本身才是资产,不该下个月重来。
所以把大纲拆成两半:数据部分保留占位符,每次重新注入;结构部分(章节、看板表头、手填的分析结论)属于定稿内容,复用时不改动。
于是复用逻辑变成:
if 项目目录里已有该客户的大纲:
    以它为骨架 → 只重新拉数据注入 → 跳过重复的结构调整
else:
    用模板生成 → 用户调结构 → 确认后定稿存盘
还有一条容易被忽略、但很关键的工程约定:数据重拉与内容增删改不要混在同一轮,否则用户手动改的文字会被下一次刷新覆盖。
流程里设了一道硬闸门:只有用户明确确认,才生成 PPT,不接受「看起来差不多就出片」。
理由不是流程洁癖:结构错了的 PPT 比没有 PPT 更麻烦——它会流到客户手里。闸门卡在「人已经看过大纲」和「机器开始渲染」之间,把纠错成本压在最低的那一侧。前面还配了一道格式闸门,先问清楚要 PDF / PPT / Word 还是只要 Markdown。
这套东西要长期跑、换人跑,所以同源指标却口径相反之类的坑,全都固化成文字,而不是靠记忆传递。能写下来的规则就不该存在某个人的脑子里。
做法是不让 AI 自由发挥配色:风格直接从模板文件取,配色按品牌设计规范执行,不许用渲染器的默认配色。
规范里同时写清了不要什么——不要深色科技风、不要 HUD 界面、不要机器人元素、不要卡片堆叠。把「避免清单」写进规范,比只写「要什么」更能收敛结果,因为风格的破坏往往来自叠加,不来自缺失。
明确不做的事,和做的事一样重要:
| 不做 | 为什么 |
|---|---|
| 不在本技能内实现导出 | 导出是独立能力,转调专门 Skill,避免渲染逻辑各自演化 |
| 不在用户确认前自动出片 | 结构错了的 PPT 会流到客户手里,纠错成本远高于等一下 |
| 不补大纲里没有的数据 | 宁可少一栏,不造一个数 |
| 不硬编码凭据 | 走环境变量 |
| 不把报告写回技能包 | 技能包保持纯净、可被版本管理;项目数据留在项目里 |
| Phase | 内容 | 状态 |
|---|---|---|
| 1 | 脚本化拉数据 + 手工套模板出 Markdown | 已完成(已废弃) |
| 2 | 去脚本化:AI 直连数据源,动态组装 | 已完成 |
| 3 | 大纲复用(结构与数据分离) | 已完成 |
| 4 | 英文版大纲,支持外客户报告 | 已完成 |
| 5 | 决策闸门 + 自查清单,把模型的直觉动作标成错误项 | 已完成 |