内容在 CMS 里以 Markdown 写就,对外要 HTML 文章页、给客户要 Word、归档要 PDF——同一份源文、三种交付物、一个 HTTP 接口,且三种产物必须「看起来是同一个东西」。
CMS 案例 · 内容导出服务 · 2026
| 项 | 内容 |
|---|---|
| 类型 | CMS 案例 · 内容导出服务(内部工具) |
| 场景 | CMS 内容的多形态交付:网页文章 / 客户文档 / 归档件 |
| 形态 | 常驻 HTTP 服务,提交 Markdown,按格式返回产物 |
| 语言 / 运行时 | Python · uv 管理环境与依赖 · ASGI 服务 |
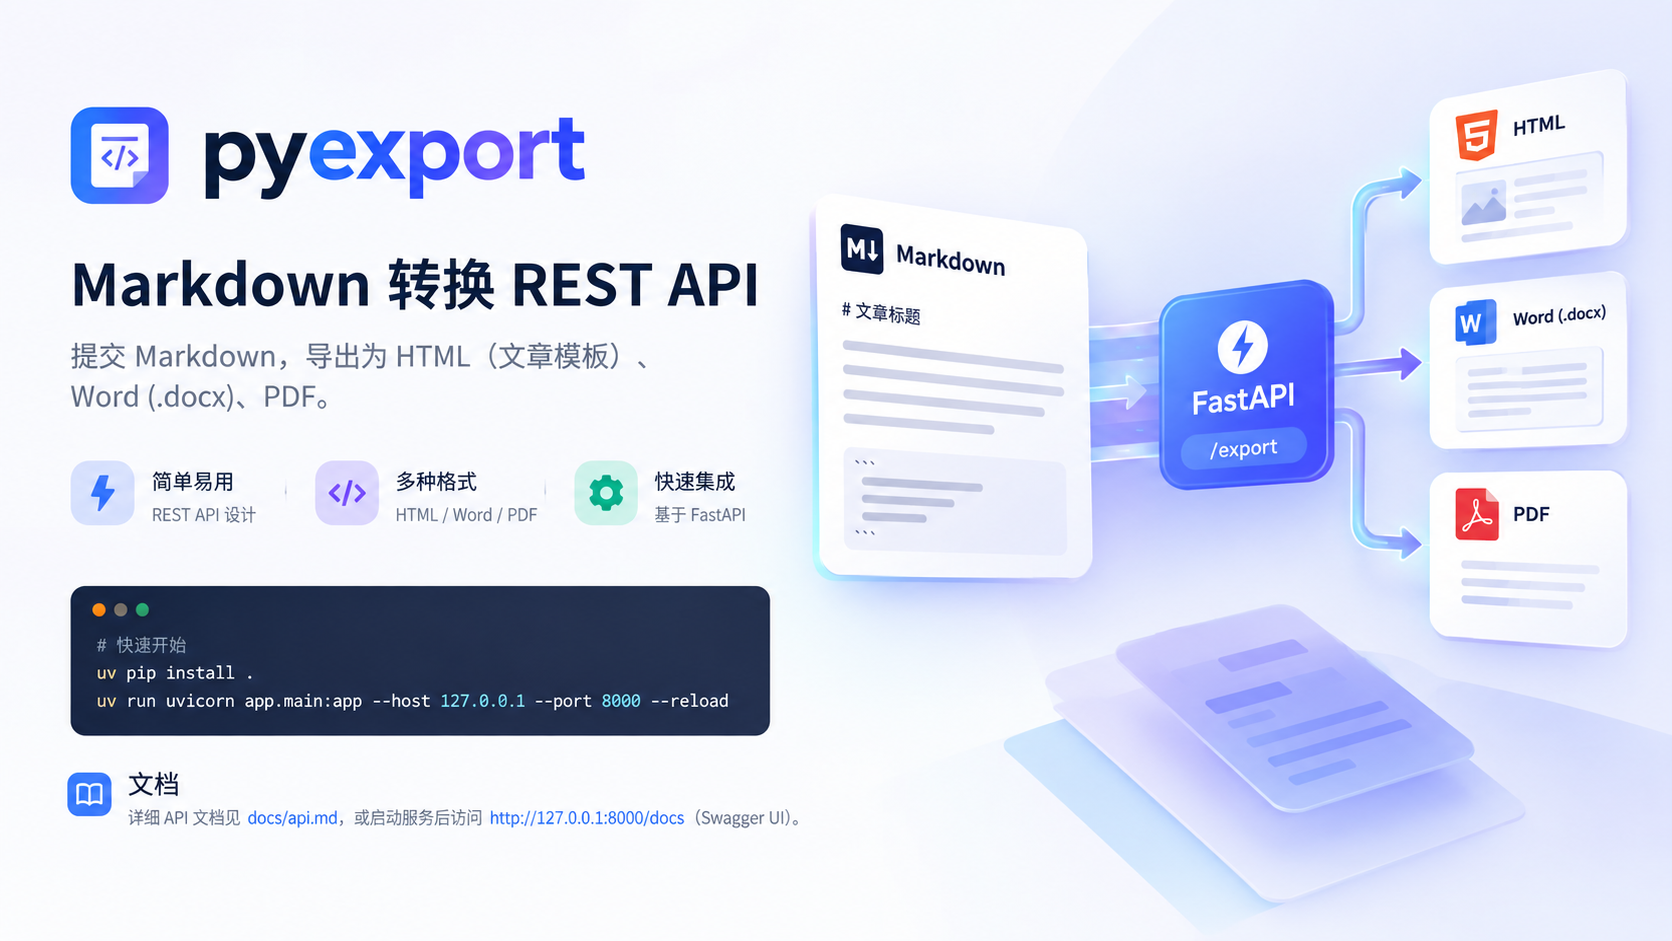
| 输出格式 | HTML(文章模板)· Word(.docx)· PDF |
| 接口文档 | docs/api.md + 服务自带 Swagger UI(/docs) |
| 设计立场 | 一次解析、多点渲染;不做链式格式转换 |
| 默认部署 | 绑定 127.0.0.1,作为内网/本机能力,不是公网服务 |
CMS 里的内容从此只有一个源头:Markdown。但 Markdown 不能直接交付给任何人——它得先变成某个具体的东西:
原本的做法是人工导出:从编辑器复制到 Word,从浏览器打印成 PDF。三个问题立刻出现——格式会丢(标题层级、代码块、表格全糊)、分页不可控(PDF 断在代码块中间)、每次导出的东西都不一样(同一个人隔天导都能不一致,何况换人)。
所以这件事的目标只有一句:把「导出」从人的手上拿走,变成一个可被调用的确定性动作。
POST Markdown
   │
   ├─ 解析与校验 ──→ 中间结构(AST,只解析一次)
   │                     │
   │        ┌────────────┼────────────┐
   │        ▼            ▼            ▼
   │   HTML 渲染      DOCX 组装    打印样式 HTML
   │   (文章模板)    (样式表)    → 渲染 PDF
   │        │            │            │
   └────────┴────────────┴────────────┘
                  返回产物字节流
用户体感:丢一段 Markdown 进去,指明要哪种格式,拿回一个文件。
架构上最要紧的一个决定是那句「只解析一次」——不做 Markdown → HTML → Word → PDF 的链式转换。链式转换每过一手就丢一次结构:HTML 转 Word 丢语义(只剩样式),Word 转 PDF 丢字体和分页控制。三种产物应该一起从源文长出来,而不是从彼此的残渣里再长出来。
表格扩展、围栏代码块、任务列表、脚注、行内公式……每开一个开关都改变解析结果。同一段文本在两个「都支持 Markdown」的工具里渲染出不同结构,是常态。
所以不承诺「什么 Markdown 都吃」:先把支持的方言固定下来、按同一套开关解析,并写进文档。输入边界显式化,是为了让输出可预期——一个转换服务最怕的不是不支持某项语法,而是「这次支持、下次不支持」。
这是整套东西最容易被忽略、也最容易埋雷的地方。
Markdown 里有不少表达,在 DOCX 里根本没有对应物(复杂的嵌套表格、多层脚注、某些内联标记)。当渲染器遇到映射不了的结构时,最省事、也最危险的做法是「跳过它」——产出会成功,文件能打开,内容却少了一截,而且没有任何人会发现,因为少的那部分在产物里看起来本来就不存在。
所以定了一条硬规则:映射不了的结构,要么降级成最接近的形式并明确记录,要么直接报错。 宁可失败得响亮,不要成功得残缺。
分页会摧毁排版:表格被拦腰切断、代码块断行、小标题孤零零留在页尾。这些在 HTML 里永远不会出现,只有在出 PDF 的那一刻才暴露。
做法是走打印链路并在样式层显式处理——表格与代码块不允许跨页断开、标题不与后文分离、页边距与页眉页脚由样式统一控制,而不是交给渲染器默认值。
与之绑定的第二个坑是字体:中文 PDF 必须把字体内嵌进文件,否则在没装该字体的机器上会静默替换字形,甚至渲染成方框。HTML 输出不会有这个问题,所以它只会出现在 PDF 上——这类「只在一种格式里出现」的故障,正是多格式服务最容易漏测的地方。
DOCX 是另一套排版模型:流式的段落 + 命名样式,没有 CSS 的盒模型、没有层叠、没有伪元素。
如果按 HTML 的思路逐段刷字号和颜色,产物在 Word 里会变成一堆「看着像、但改不动」的硬格式化文本——客户改一个标题字号,整篇的层次感就散了。
所以 DOCX 渲染要落到命名样式上:Markdown 的标题层级映射到 Word 的标题样式,代码块映射到独立的代码样式,引用映射到引用样式。这样产物是「活的文档」——对方能在 Word 里统一样式、生成目录、走修订。
Markdown 只要来源不完全可控(外部投稿、历史迁移、模型生成、第三方系统推送),它转出的 HTML 就不能直接塞进页面——Markdown 本身就允许内联 HTML,等于把一段未经检查的标签结构放进站点的渲染路径里。
所以清洗必须发生在渲染阶段,走标签/属性白名单,并且文章模板自身不引入外部脚本与远程资源。这条不是「以后再说」的加固项,而是这个接口能不能对外提供的前提。
DOCX 与 PDF 是重活,长文会直接把请求顶到超时。这决定了接口形态:
还有一条安静但重要的设计声明:服务默认只监听回环地址。这不是没配好,而是明确的意图表达——它默认是一个内网能力,要对外提供必须再显式配置鉴权、限流与部署方式。默认值就是安全策略的一部分。
| 能力 | 输入 | 输出 | 说明 |
|---|---|---|---|
| Markdown → HTML | Markdown 源文 | HTML 片段/文档 | 套用文章模板,产出即文章页可用 |
| Markdown → Word | Markdown 源文 | .docx | 落命名样式,产物在 Word 里可继续编辑 |
| Markdown → PDF | Markdown 源文 | .pdf | 打印样式 + 分页控制 + 字体内嵌 |
| 文档 | — | — | docs/api.md;服务启动后 /docs 为 Swagger UI |
实际路由、请求体字段与响应头以 docs/api.md 与 /docs 为准——接口文档是这套服务的唯一真源,本页不复述字段,避免两处口径分叉。
| 不做 | 为什么 |
|---|---|
| 不做 Markdown 编辑器 | 编辑是 CMS 的职责;这个服务只负责「从源文到产物」这一步 |
| 不做链式转换(HTML → Word → PDF) | 每过一手丢一次结构,产物会逐级退化 |
| 不承诺支持任意 Markdown 方言 | 方言固定并写进文档,输出才可预期 |
| 不静默丢弃无法映射的结构 | 残缺的产物比失败的请求更贵——它没人会发现 |
| 不清洗就直接输出 HTML | 产物要进页面,白名单清洗是前提而非加固 |
| 不默认对外监听 | 默认绑 127.0.0.1;要对外必须先显式加鉴权与限流 |